大模型推理服务冷启动加速:从首实例到批量扩容
随着大模型应用规模扩大,推理服务已成为AI基础设施的核心工作负载。对平台来说,面临的问题也不再只是“如何把模型跑起来”,还包括如何让算力供给及时跟上业务需求的变化。
在MaaS平台中,不同模型的请求量差异很大,同一模型的流量也会随时间呈现明显的波峰与波谷。理想情况下,GPU资源应该随需求动态流转:业务高峰时快速扩容达到服务的目标容量,业务低峰时及时释放算力资源,供其他业务使用。但实际运行中,即使平台能够及时分配GPU,推理服务也不一定能马上扩容到目标容量。
这是因为,获得GPU资源只是推理实例启动的第一步。接下来还需要完成框架初始化、模型权重加载,以及缓存准备、内核编译、CUDA Graph捕获等工作,才能真正开始处理请求。这些步骤往往需要较长时间,使得新增的GPU算力无法立即转化为服务能力。为了应对流量上涨,平台不得不提前扩容,或者在低谷时保留一定数量的备用实例,从而造成额外的资源开销。
因此,启动和恢复的速度,不仅决定了推理服务响应流量变化的能力,也影响着GPU资源能够被多大程度地弹性利用。
那么,如何减少每次扩容启动时重复的准备工作,就成为了问题的关键。例如,提前缓存模型文件,在节点之间共享已下载的文件,或者从已有实例的GPU获取模型权重。这些方案虽然解决的问题不同,但有一个共同思路:提前完成准备工作,或复用已有数据,减少新实例启动时的重复开销。
本文将围绕这一思路,从首实例启动和批量扩容两个场景展开:先讨论模型预热、缓存与并发加载,再讨论P2P模型文件分发和GPU权重直传,分析哪些准备工作可以提前完成,哪些数据可以在实例之间复用。
一、冷启动链路与耗时分析
推理服务的冷启动主要涉及两类场景:一类是新模型首次部署,需要从零创建推理实例;另一类是模型已经运行,需要快速扩容。两个场景在实例维度都需要创建新的推理引擎,但可以复用的资源并不相同。首实例通常需要从模型仓库准备权重,而后续扩容的实例则有机会复用已运行实例产生的状态数据。因此,冷启动加速的不仅要关注单个实例启动耗时,也要考虑多个实例并发启动的效率。
1.1 推理服务的启动过程
在讨论具体的加速技术之前,先看看一个推理实例从创建到能够处理请求,需要经历哪些步骤。从平台侧来看,整个过程包括资源分配、容器启动、推理引擎初始化以及服务就绪。其中,引擎初始化涉及模型加载、运行时编译、缓存准备等多个环节;完成初始化后,推理实例还需要通过就绪检查并加入服务路由,才能承接新的推理请求。
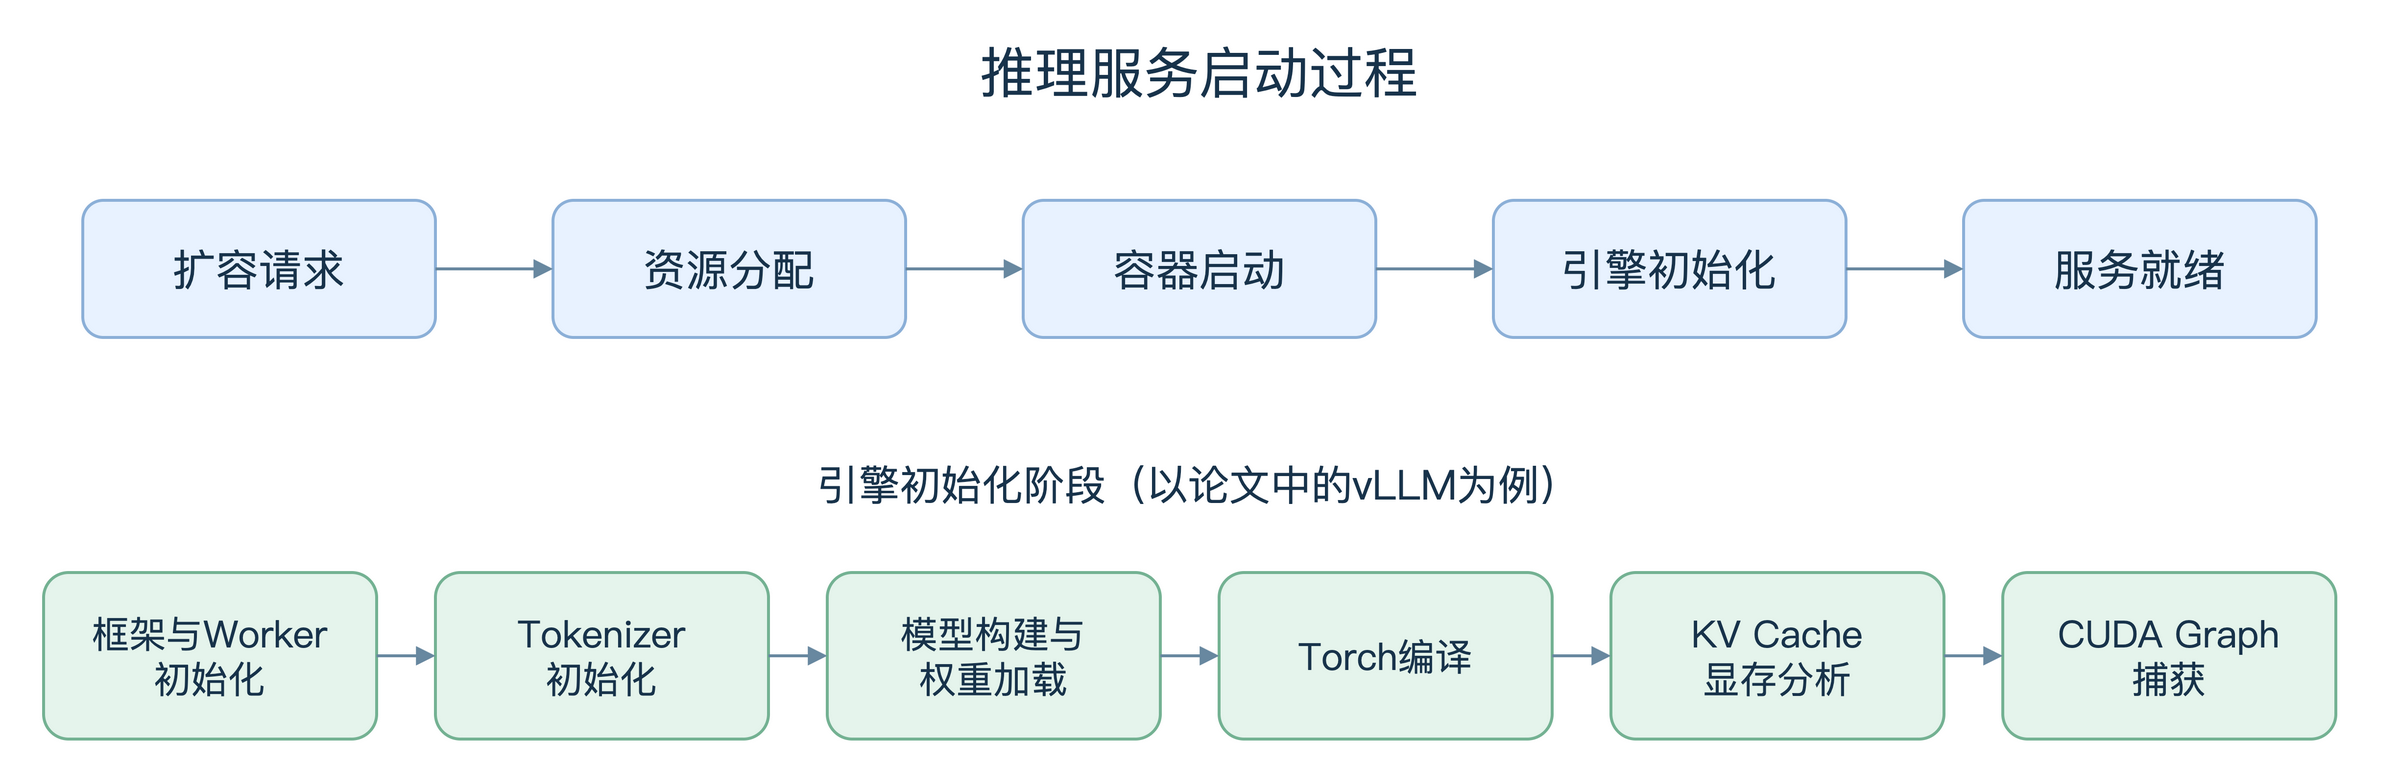
从耗时构成来看,可以将整个启动过程拆分为:
T_ready ≈ T_资源分配 + T_容器启动 + T_引擎初始化 + T_服务就绪
这里的T_ready表示从扩容请求发起到实例具备接流能力的时间。实际系统中,部分工作可以提前执行或相互重叠(并行完成),因此需要结合启动链路的关键路径来分析耗时。
进一步看推理引擎内部,MLSys 2026 论文《Breaking the Ice: Analyzing Cold Start Latency in vLLM》 以vLLM v0.10.1.1为研究对象,将引擎启动划分为六个主要阶段:
- Framework Bootstrapping:框架引导,包括运行环境、依赖模块和Worker初始化。
- Tokenizer Initialization:分词器初始化,加载词表,建立文本分词所需的数据结构。
- Model Loading:模型加载,将预训练权重加载到GPU显存。
- Torch Compilation:Torch编译,通过TorchDynamo转换计算图,并编译或加载已有的编译产物。
- KV Cache Profiling:通过模拟前向计算(Dummy Forward)测量运行时显存占用,确定可分配给KV Cache的显存容量。
- CUDA Graph Capture:针对预设的计算形状进行预热和图捕获,减少后续推理的CPU调度与Kernel Launch开销。
论文进一步对各阶段进行了耗时分析。以Llama 3.2-3B为例,在H100测试环境下,vLLM引擎启动总耗时为20.32秒。其中,框架依赖加载、计算图转换和编译产物加载等环节占据了较长时间。
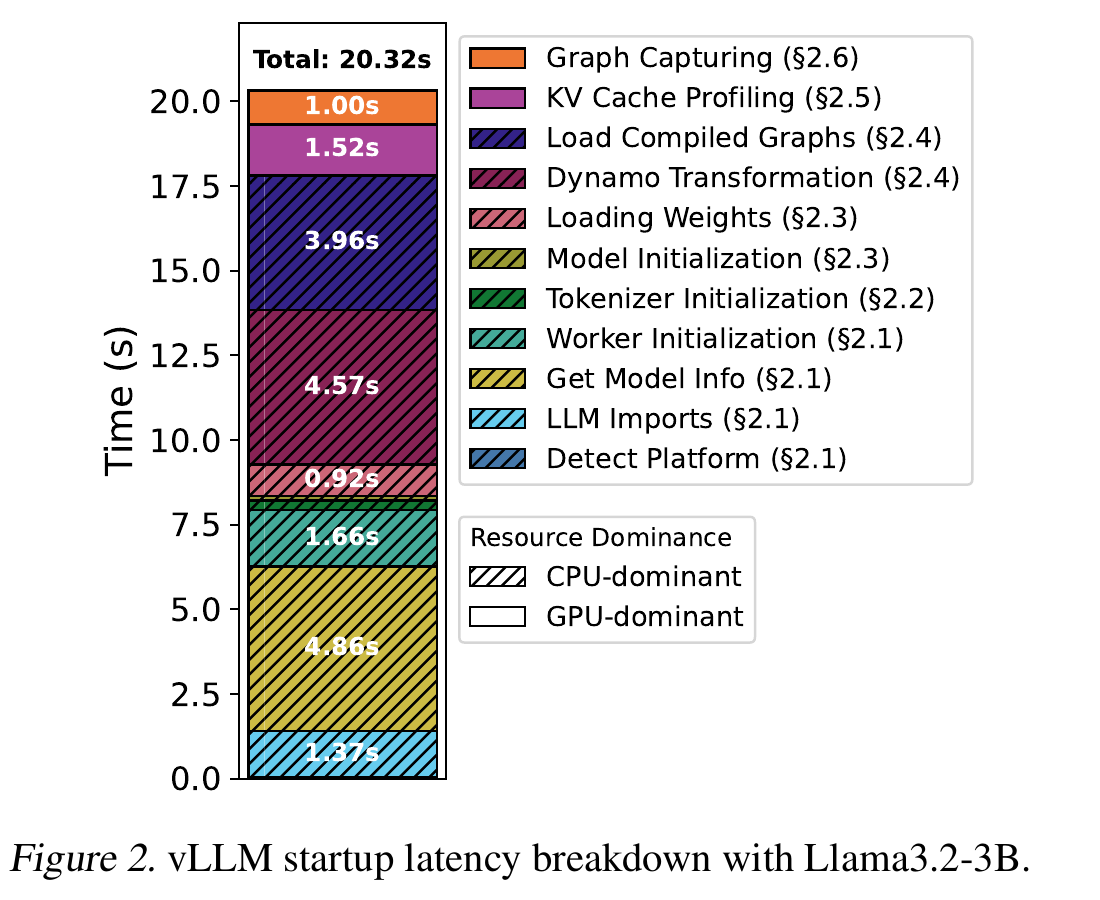
需要注意的是,论文主要研究引擎自身的初始化过程,实验中的模型权重文件已位于Linux文件缓存中,编译缓存也已准备好,因此权重加载耗时相对较低。而在更大规模的模型部署中,权重加载可能成为主要瓶颈。例如,SGLang Fast Engine Recovery 对Ling-2.6-1T FP8的启动分析显示,在其测试环境下,约527秒的启动耗时中,权重加载约占495秒(93.9%)。
两组数据表明,推理引擎的启动耗时分布与模型规模、缓存状态及运行环境密切相关。权重获取与加载、框架初始化、计算图编译和CUDA Graph捕获等环节,都可能成为不同场景下的性能瓶颈。因此,启动加速需要结合实际耗时分布,确定哪些准备工作值得优化,哪些已有状态可以复用。
接下来先从模型权重入手,讨论如何通过模型预热减少首实例启动时的数据准备时间,以及如何在批量扩容时复用已有权重,减少重复传输与加载。
二、首实例启动:模型预热与多级缓存
先看看首实例启动场景。模型首次部署时需要从远端模型仓库拉取模型文件(包含模型权重、模型结构配置文件、Tokenizer分词器文件及相关索引文件),并下载至计算节点的本地存储,供推理引擎后续加载至GPU显存。
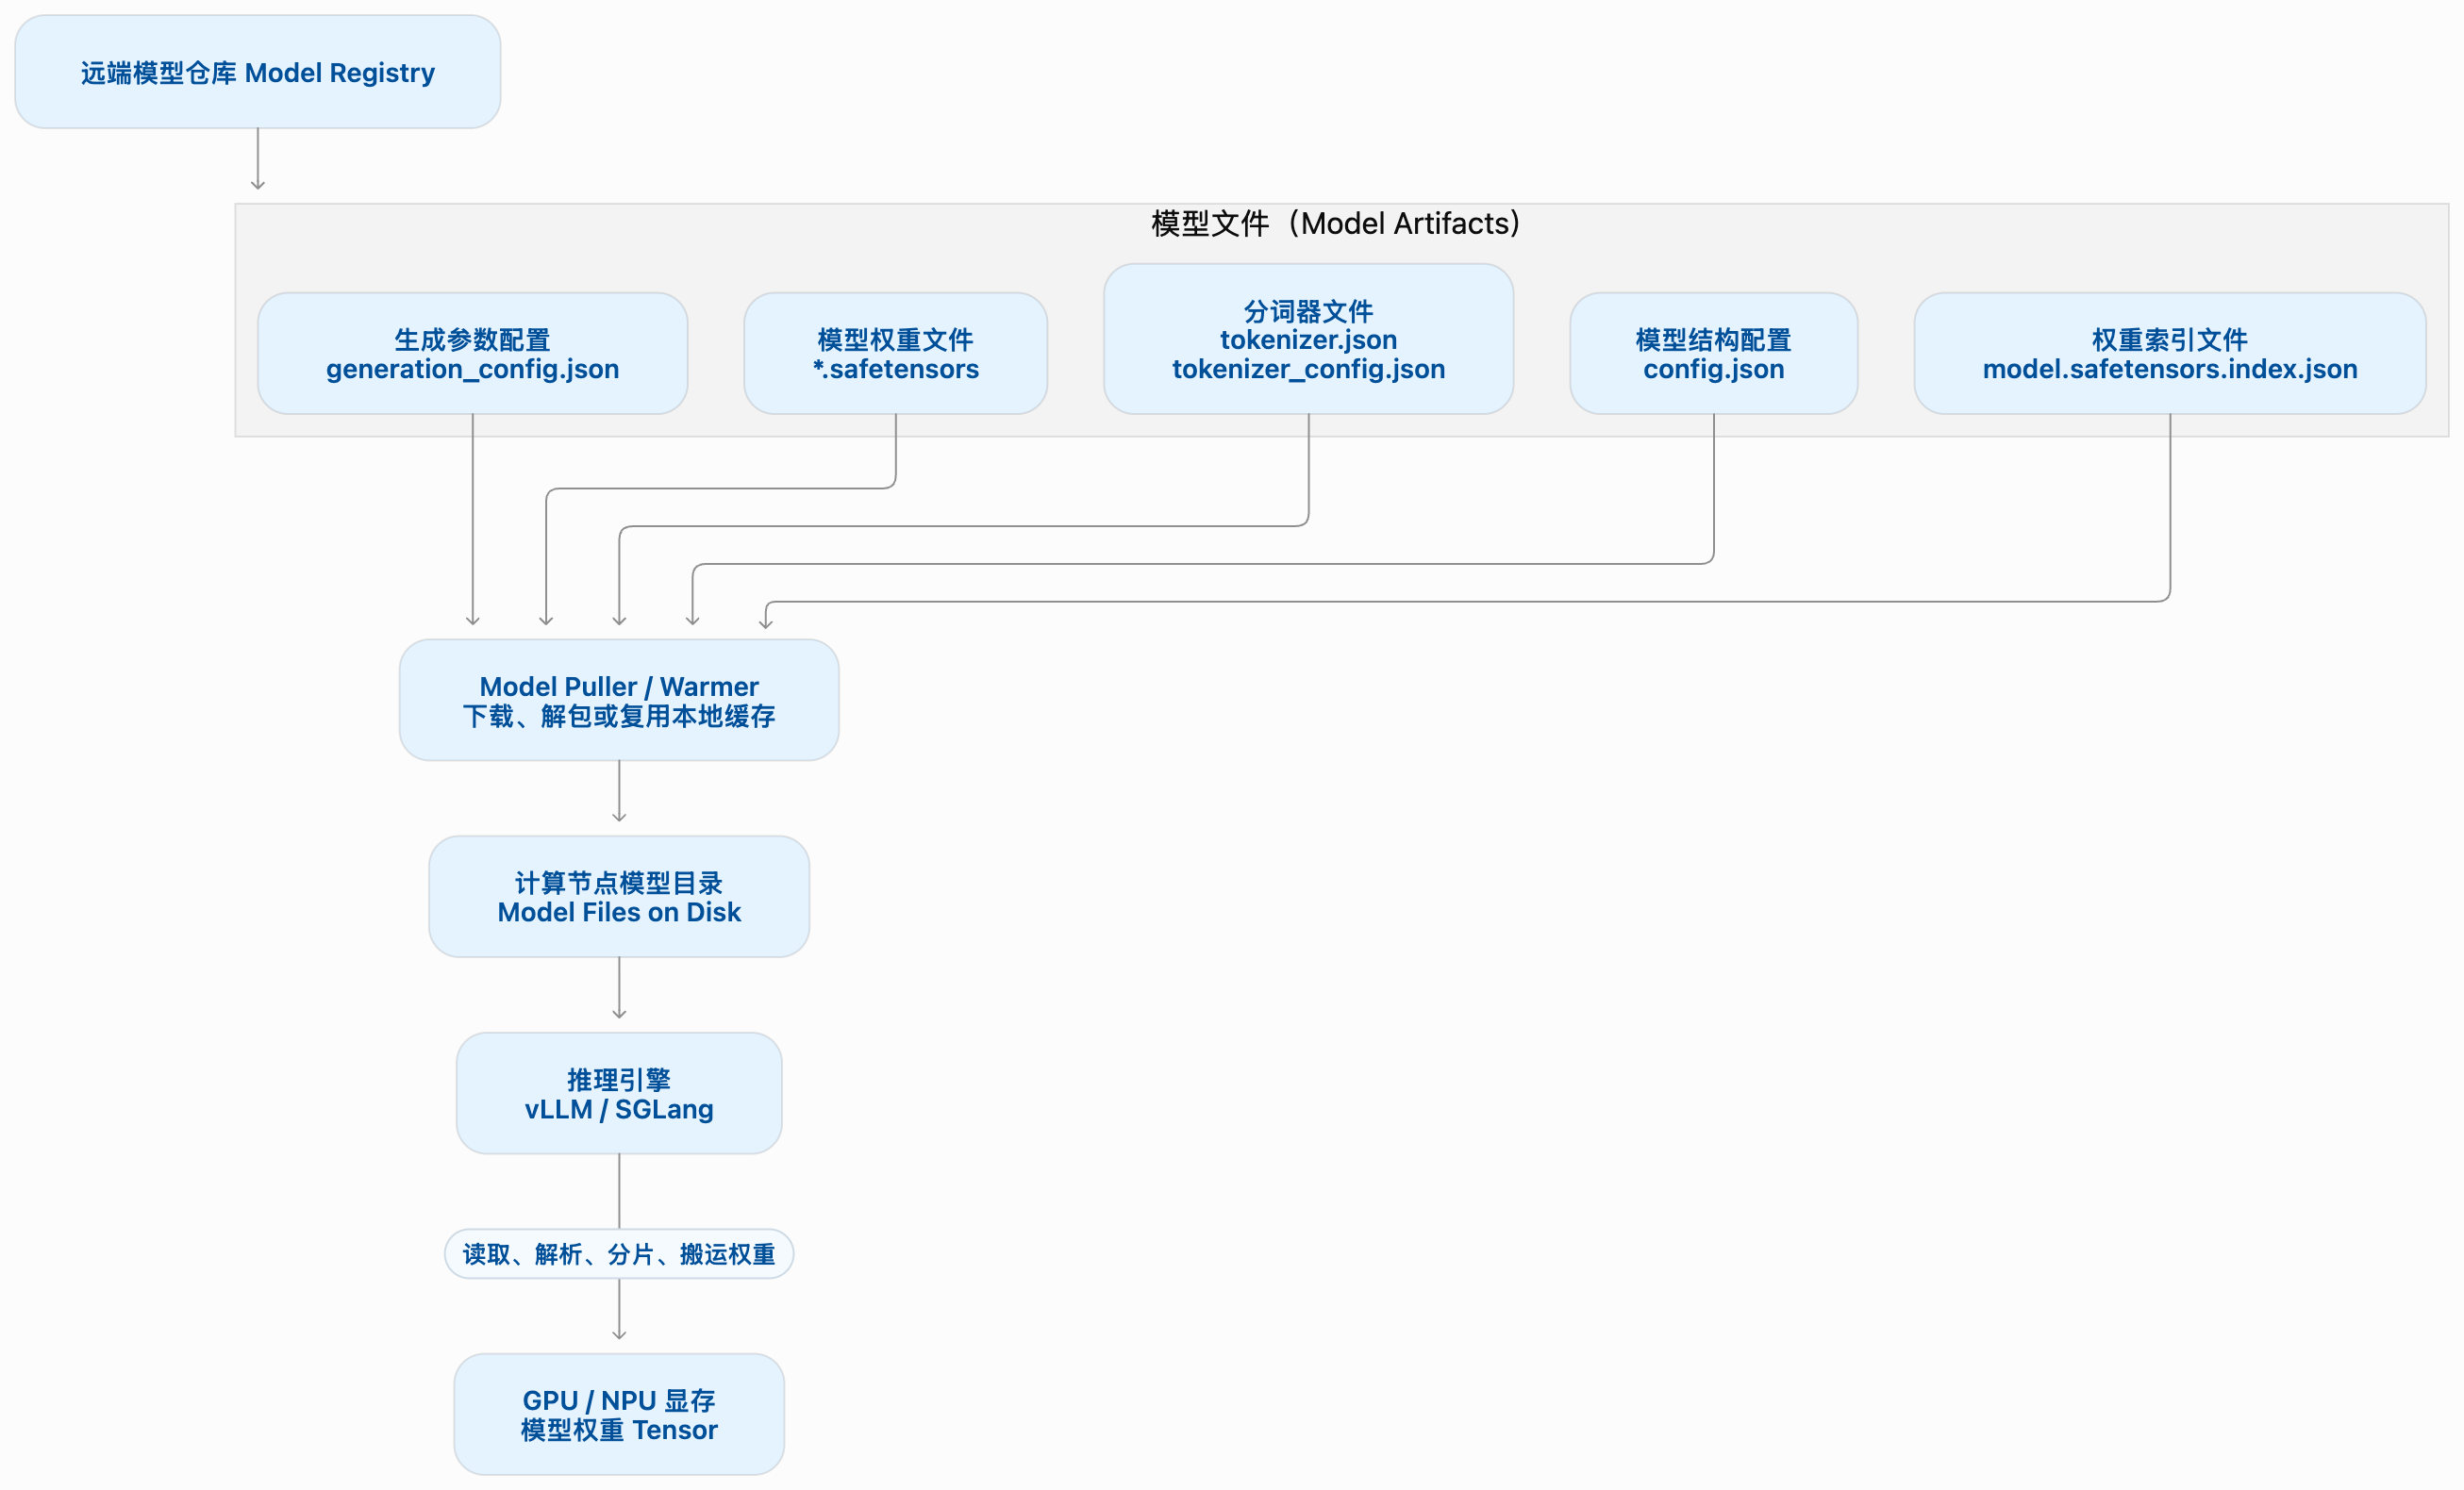
模型文件下载与加载处于启动关键路径,导致就绪等待长。针对新模型首次部署的场景,将权重准备工作前移,减少首实例启动时的数据下载与加载等待。
2.1 模型预热与多级缓存
对于首次部署的模型,如果目标节点尚未缓存对应的权重文件,推理实例就需要在启动时从远端存储获取模型数据。对于数百GB的模型,远端读取和数据传输可能带来5分钟级别的开销。
一种直接的优化方式是将模型准备工作前移。根据模型部署和调度需求,提前将模型权重预热至目标节点,使实例启动时直接从本地磁盘读取权重,减少从远端拉取模型的耗时。
根据缓存的位置与存储介质,可以考虑以下两种方案。
方案一:本地 SSD/RAID 缓存
提前将模型权重从远端存储预取到计算节点的本地SSD。实例启动时直接从本地磁盘读取权重,减少对远端存储和网络带宽的依赖。并且还可以通过多块SSD组成RAID阵列,利用磁盘聚合带宽,提高大模型权重的读取吞吐。
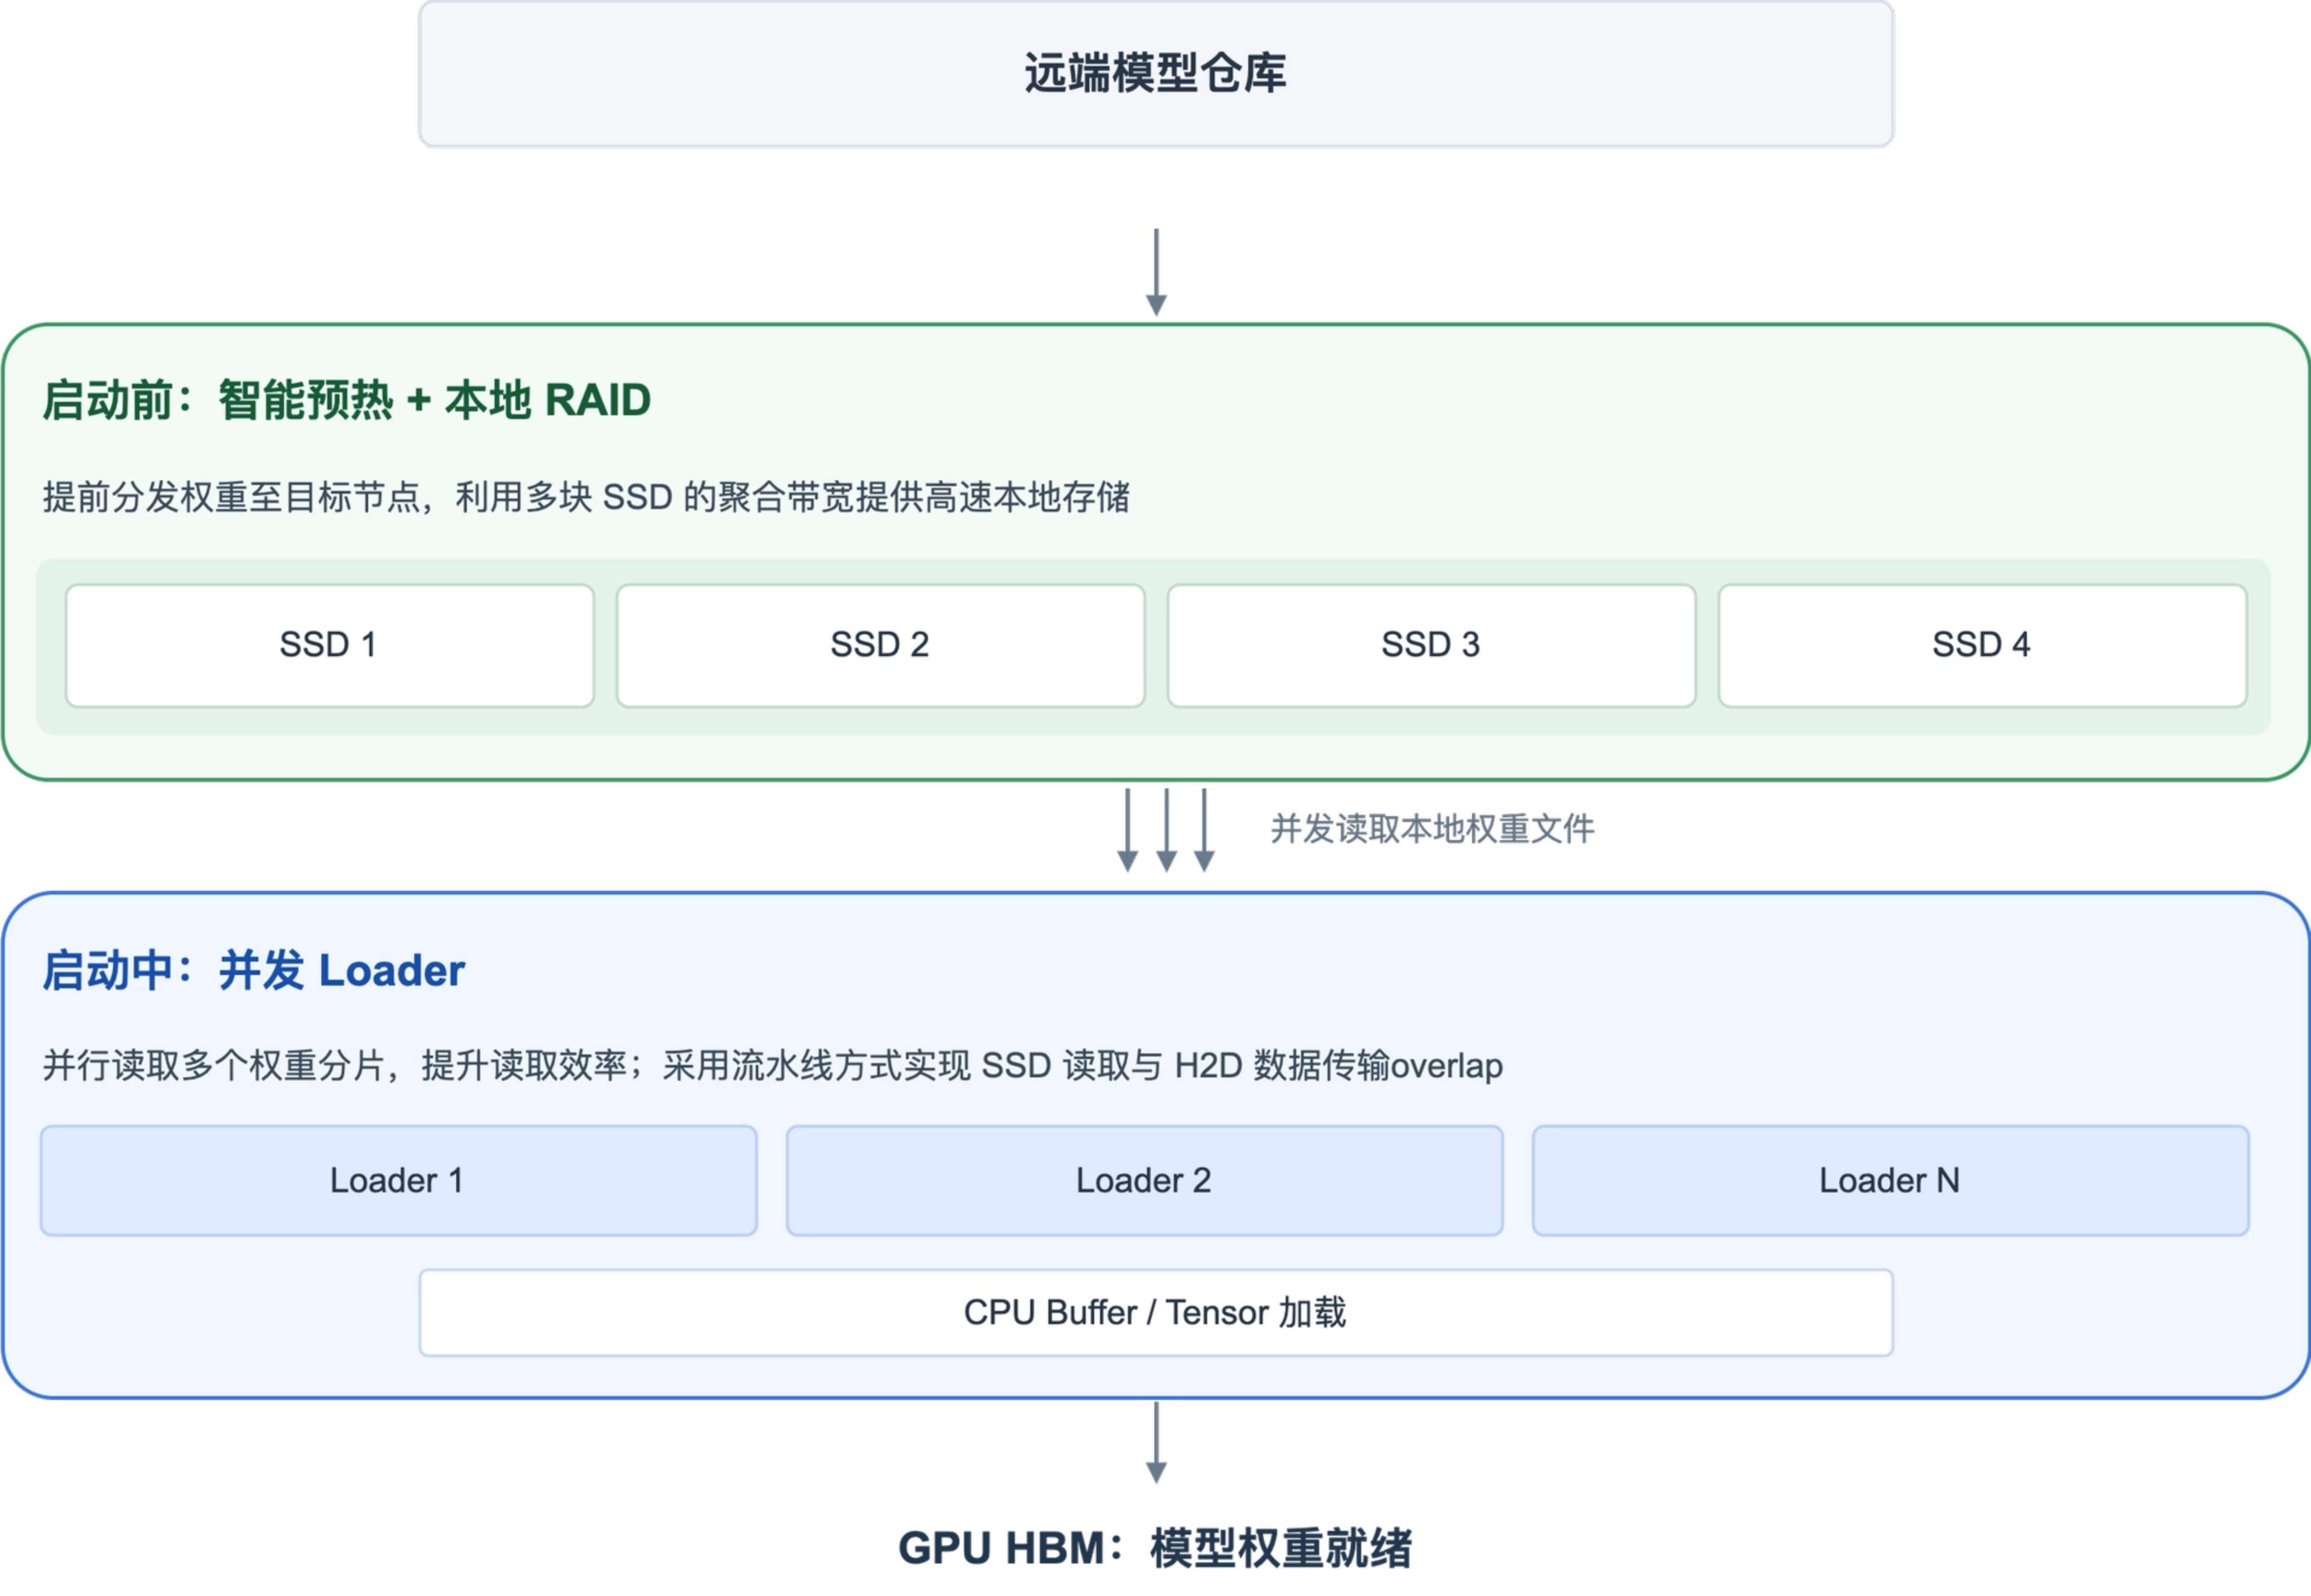
本地缓存的数据路径相对简单,但容量受限于单机磁盘;而且缓存与计算节点绑定,当模型数量较多时,还需要结合模型版本、节点资源情况,管理预热机位与缓存淘汰,避免存储空间问题。
方案二:分布式内存缓存
另一种方式是利用多个缓存节点的主机内存,构建共享的模型权重缓存。模型文件可以按分片存储在不同节点,推理实例启动时通过RDMA并行读取所需的权重数据。
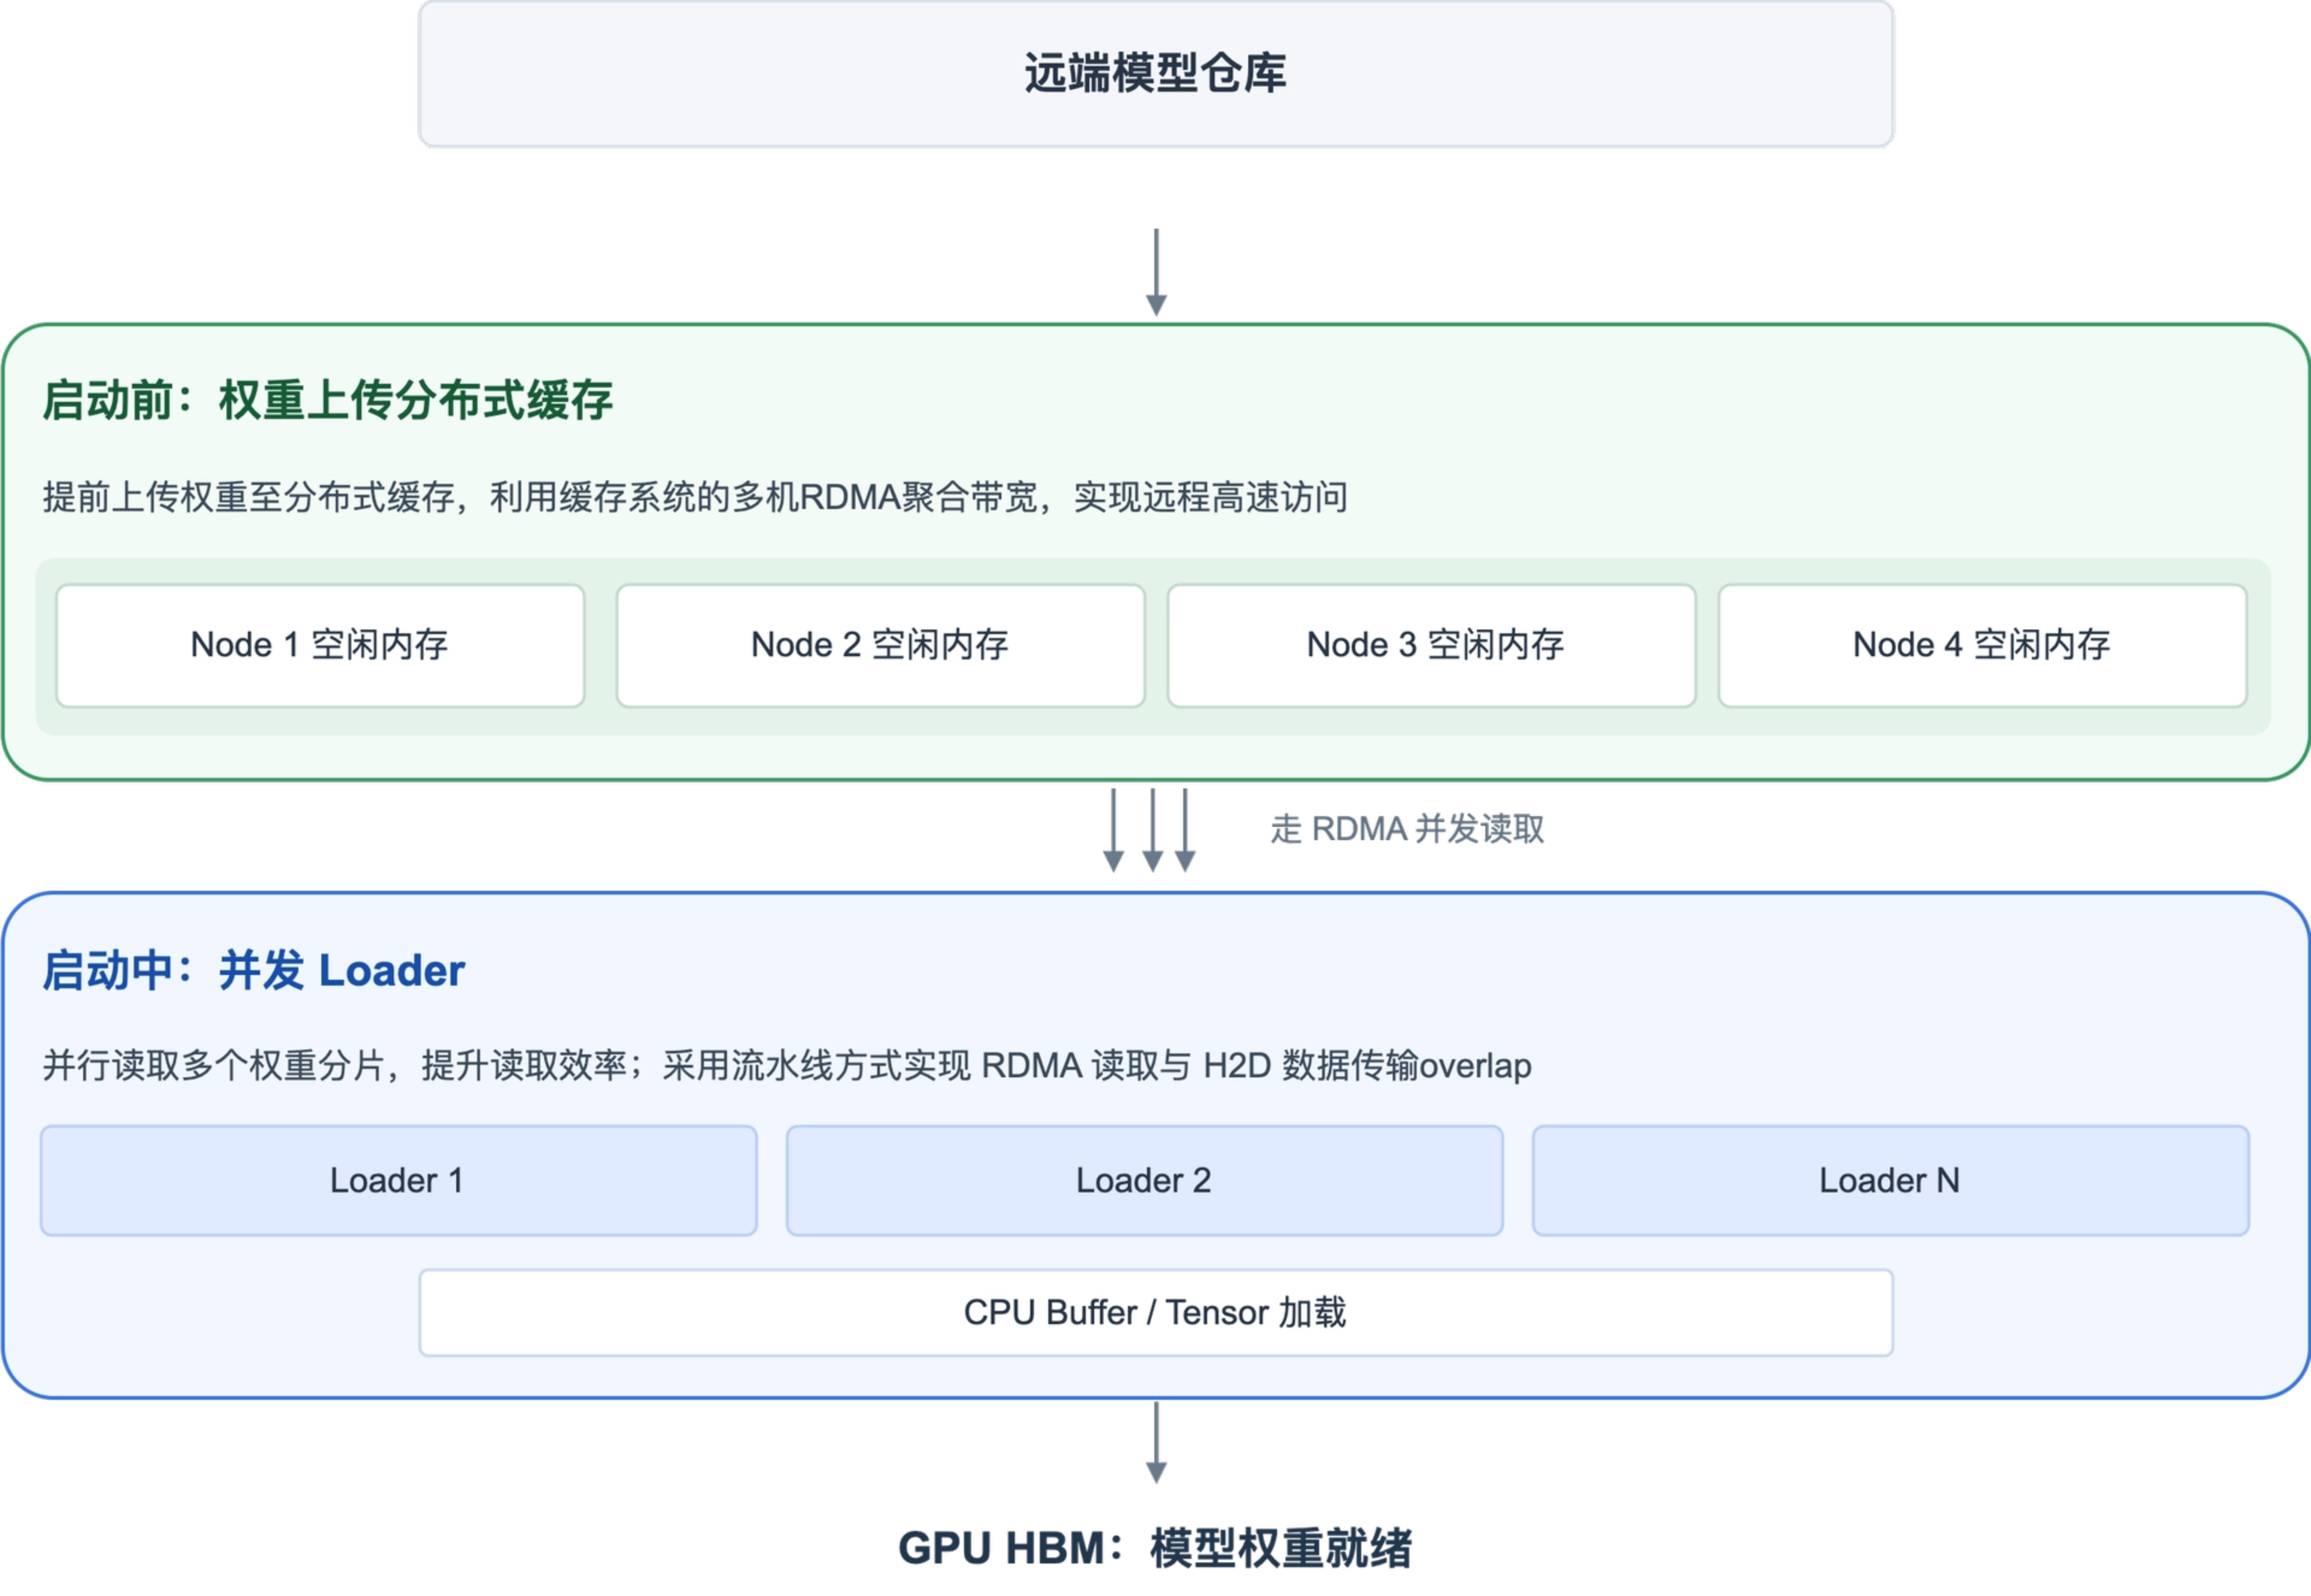
相比本地缓存,分布式内存缓存能够聚合多个节点的容量,减少模型权重对单机磁盘空间的依赖,也便于不同计算节点共享已缓存的数据。但这条路径需要依赖网络传输,还需要额外处理缓存分片管理、网络竞争及故障恢复等问题,系统复杂度更高。
两种方案各有取舍:本地缓存更适合部署位置相对稳定、能够提前完成模型预热的场景;分布式缓存则适合模型种类较多、缓存共享需求较强的场景。两者也可以组合使用,形成不同存储介质之间的多级缓存。
需要注意,模型预热并没有消除首次获取权重的成本,而是将数据准备提前到实例启动之前。实际收益取决于缓存命中率、预热时机,以及启动时采用的权重加载路径。
2.2 并发Loader与流水线加载
权重预热到本地磁盘后,推理引擎读取权重,再将其搬到GPU显存。在这个阶段,可以从提高读取并发度、重叠权重读取与GPU显存搬运等方面入手。
| 概念 | 核心含义 | 解决的问题 |
|---|---|---|
| 并发读取(Concurrent Loading) | 通过多线程或异步I/O,同时读取不同权重分片或数据块。 | 提高存储 I/O 并发度,充分利用本地SSD IO带宽。 |
| 流式加载(Streaming Loading) | 权重数据分批就绪后逐步交付给加载器,不必等待整个模型读取完成。 | 不必等待全部模型权重读取完成,就可以开始加载部分权重。 |
| 流水线加载(Pipelined Loading) | 在将第N批权重搬运至GPU时,同时读取第N+1批权重。 | 重叠存储I/O与GPU显存搬运,减少串行等待,缩短整体模型加载时间。 |
并发读取主要解决存储带宽没有充分利用的问题。传统串行读取需要等待前一个I/O请求完成,才能继续读取后续权重,难以充分发挥多块SSD组成的RAID或高性能存储系统的并行能力。通过多线程或异步I/O同时读取不同权重分片,在存储带宽允许的情况下提高整体读取吞吐。图中四个权重块各需2秒读取。串行读取时,D要等A、B、C全部读完才能开始。如果存储有足够的剩余带宽,可以将四个请求同时执行来提速。
流式加载改变了权重的交付方式。相比等待整个模型读取完成后再统一加载,流式加载可以将已经就绪的权重逐步交给推理引擎,使模型加载能够更早开始。这种方式减少了完整数据读取与GPU加载之间的等待,但并不意味着读取和显存搬运是并行。下图中A、B、C的读取顺序相同。采用流式加载时,A 在第2秒读完就可以交给加载器,此时B和C仍待读取。
流水线加载进一步利用存储读取与GPU显存搬运之间的并行能力。当一批权重正在通过H2D传输到GPU时,加载器可以继续读取后续权重,使不同批次的数据读取和显存搬运重叠执行。这样能够减少阶段间的串行等待,使整体加载时间逐步接近由较慢阶段决定的处理时间,而不是简单累加每个阶段的耗时。下图假设每批读取耗时2秒,从主机内存搬到GPU(H2D)耗时1秒。搬运A时开始读取B,搬运B时开始读取C,三批权重的总耗时就从串行的9秒降到理想情况下的7秒。
并发读取、流式加载和流水线加载可以组合使用,在提高存储读取吞吐的同时,尽可能重叠权重读取与GPU显存搬运,缩短单个实例的模型加载时间。
当同一个模型需要扩容多个实例时,仍然存在从慢路径重复读取和加载相同的模型权重。因此,批量扩容不仅需要提高单实例的加载效率,还需要考虑如何在不同实例之间复用已有的权重数据。
三、批量扩容:从模型文件分发到GPU权重直传
当同一个模型需要从一个实例扩容到多个实例时,各节点都需要拉取相同的模型权重。如果每个节点独立从远端存储下载,随着扩容规模增加,重复传输会集中消耗源站带宽,延长整批实例的启动时间。
与首实例启动不同,这时可以复用已经存在的模型数据。一部分是节点缓存的模型文件,另一部分是已有实例加载的权重。利用这些数据,可以减少模型文件下载和权重加载过程中的耗时。
| 维度 | 模型文件P2P分发 | GPU权重直传 |
|---|---|---|
| 复用对象 | 节点缓存的模型文件 | 已有实例中的模型权重 |
| 主要收益 | 减少从远端存储重复下载 | 减少重复文件读取和部分权重加载工作 |
| 目标实例后续工作 | 将文件中的权重加载到GPU,完成引擎准备 | 接收权重,完成剩余引擎初始化 |
| 代表方案 | Dragonfly | ModelExpress、Mooncake TransferEngine |
3.1 P2P模型文件分发
对于已经下载到集群中的模型文件,可以通过P2P方式在节点之间共享,而不必让每个新节点都从模型仓库重新下载。目标节点可以从多个Peer并行获取分片,已获取的分片又可以继续供其他节点下载,让更多节点参与分发,减少对中心存储带宽的占用。
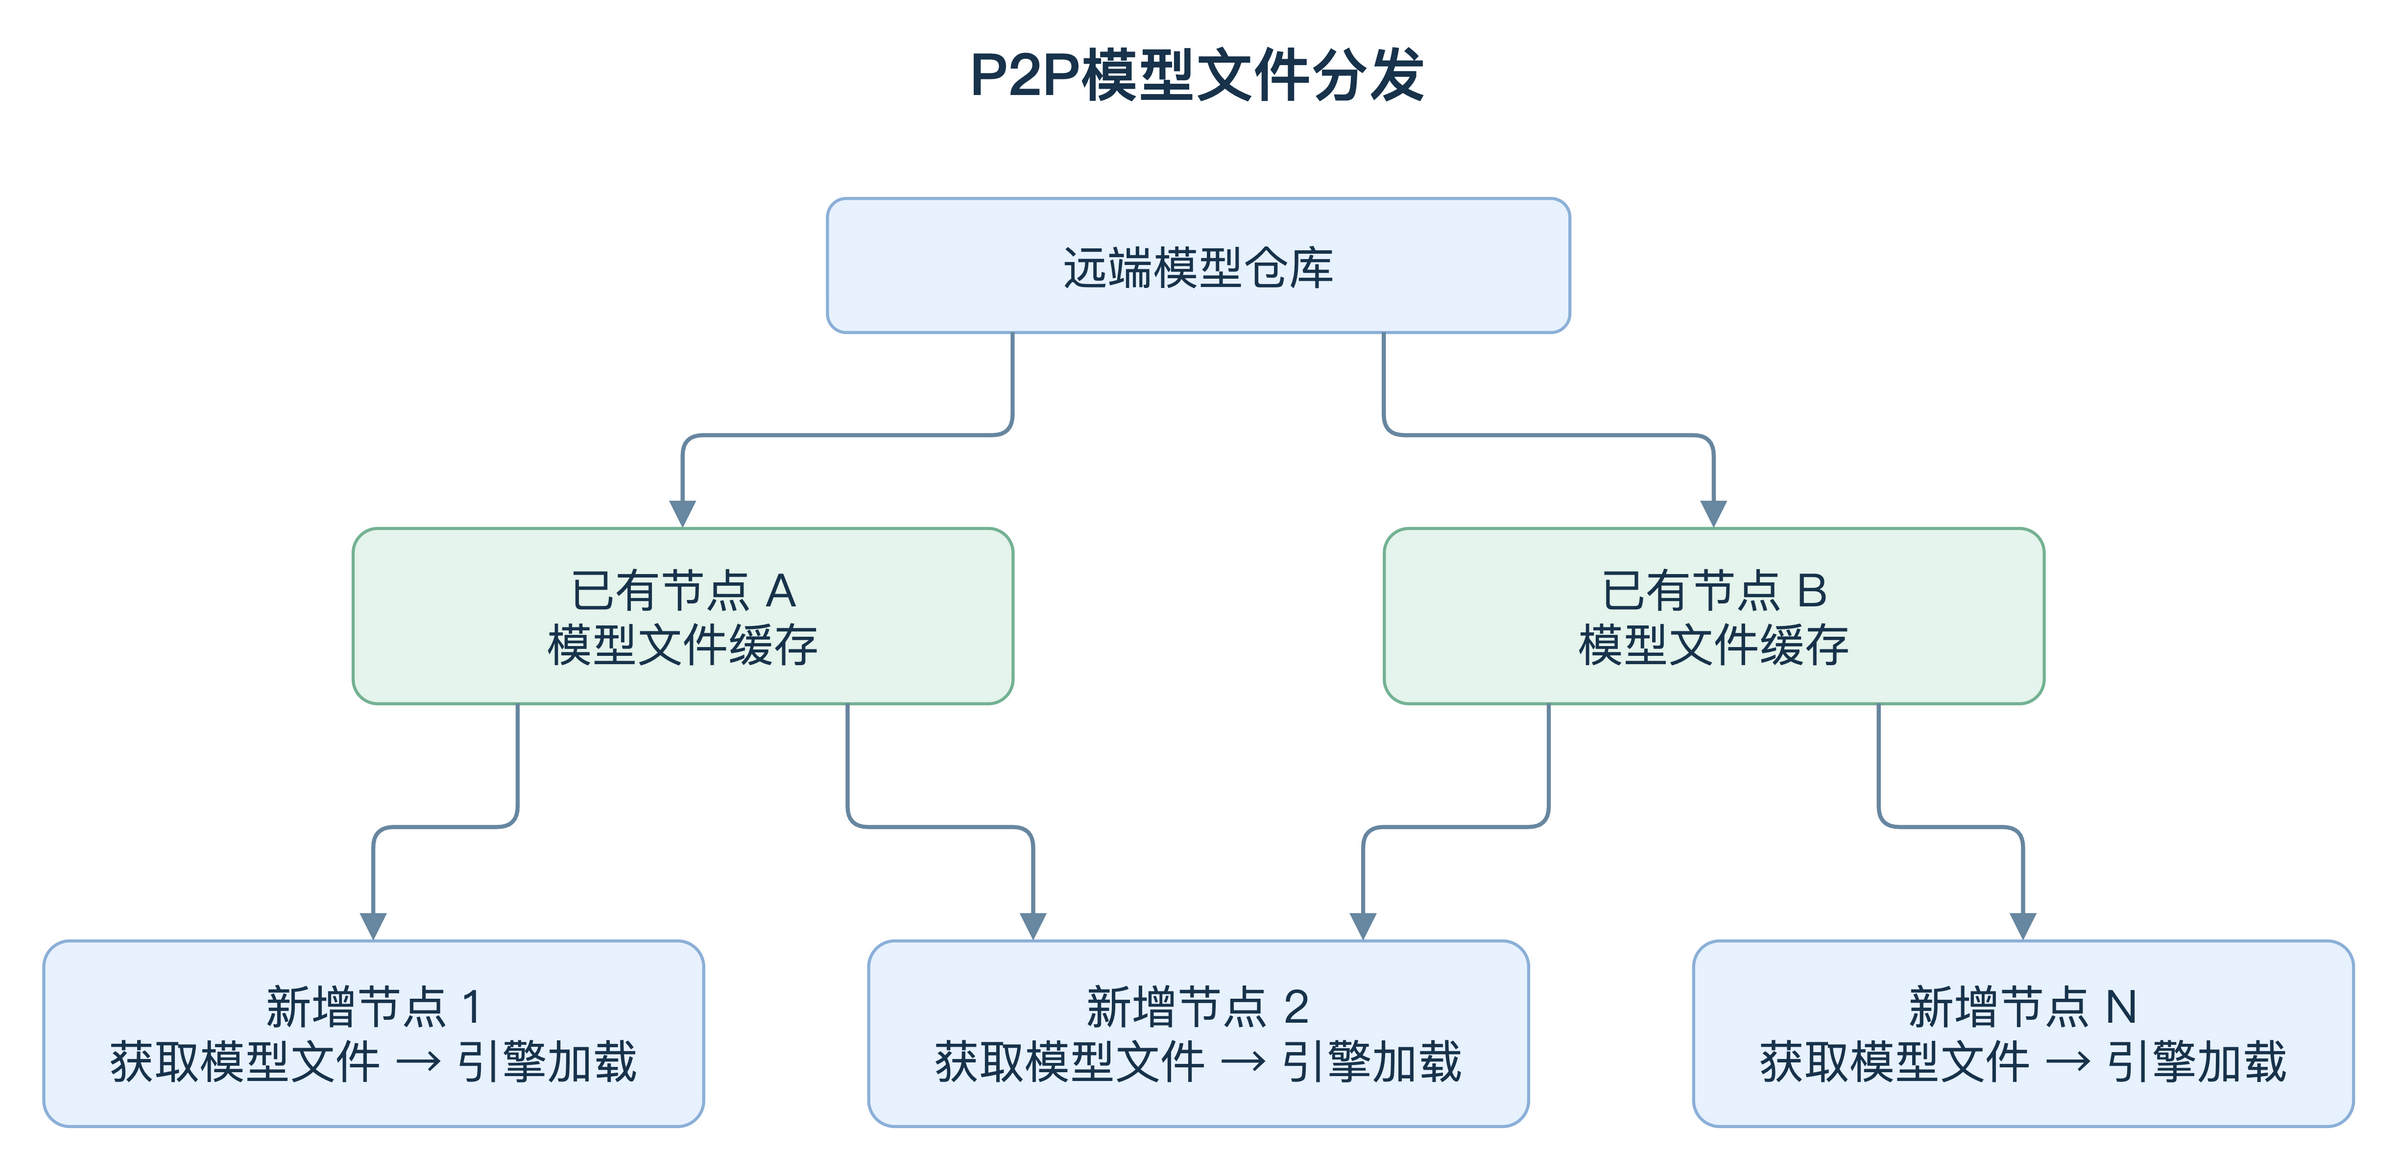
实际分发时还需要考虑模型文件的缓存分布以及可用带宽,尽量避免新的传输热点。Dragonfly就是这一方向的典型实践,通过分片下载和Peer调度,提高大规模文件分发的效率。Dragonfly文档
P2P主要解决模型文件的分发问题。文件分发完成后,推理引擎仍需读取权重并加载到GPU。这里可以继续结合并发读取和流水线加载等方式进行优化,缩短单实例的准备时间。
3.2 GPU权重直传
如果集群中已经有相同模型的实例在运行,权重复用还可以进一步延伸到GPU显存。新实例可以直接从已有权重的GPU获取权重,减少重复读取和权重处理工作。
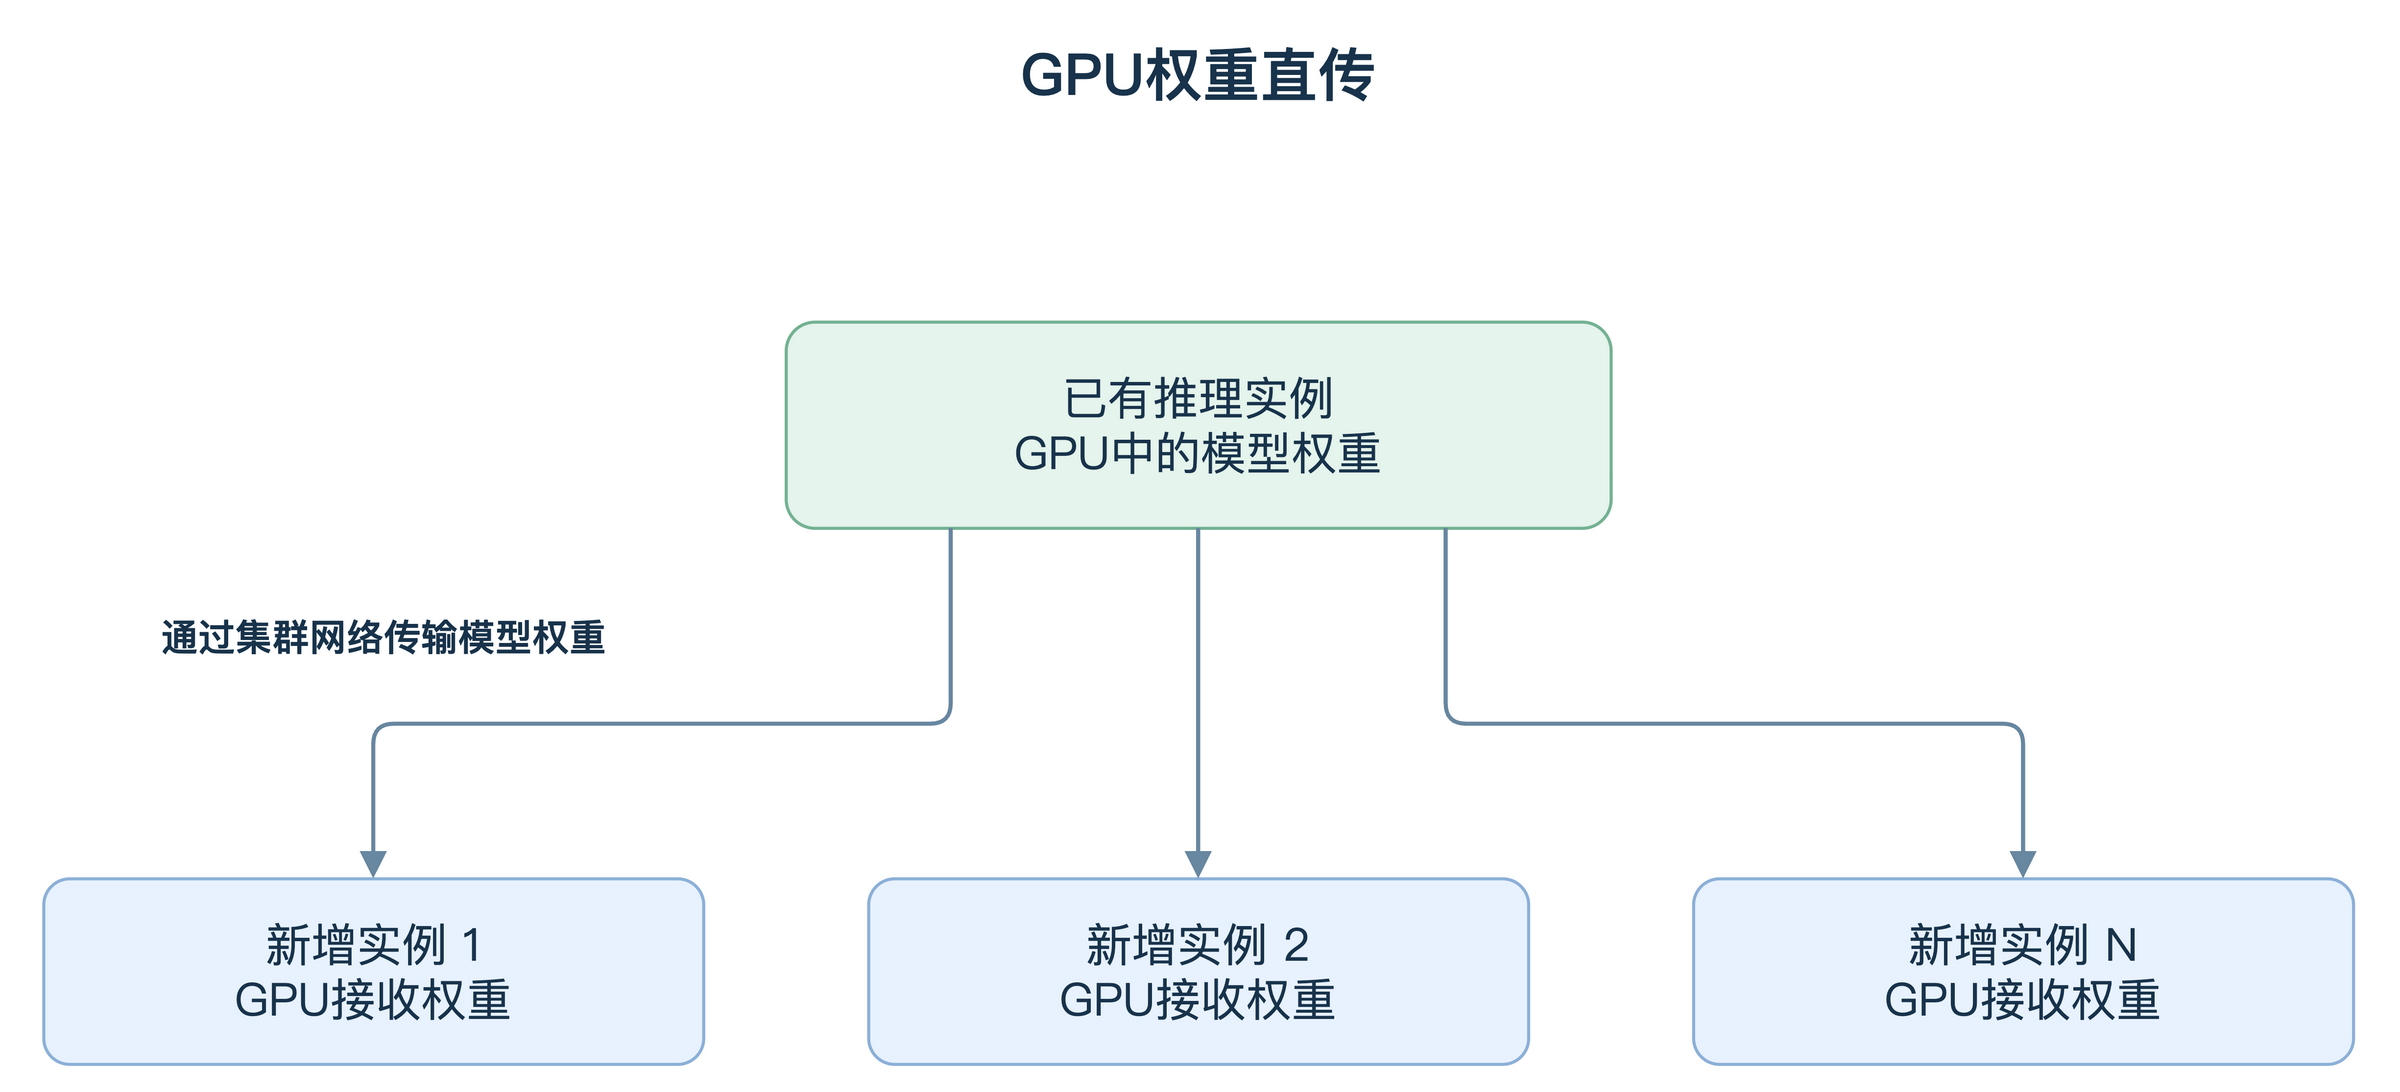
跨节点传输还需要考虑数据如何从源GPU到达目标GPU。在支持GPUDirect RDMA的情况下,网卡可以直接访问GPU显存,减少经过CPU内存中转的数据拷贝。不过,当多个新实例同时扩容时,网络带宽依然可能成为瓶颈。
业界已有相关实践:ModelExpress将权重源发现、GPU权重传输和模型加载流程结合起来。Mooncake TransferEngine则主要提供底层数据传输能力。两者并非互斥方案:ModelExpress负责权重加载与传输的协调,也可以使用Mooncake TransferEngine作为传输后端。
四、总结
推理服务的冷启动包含多个阶段,具体瓶颈取决于模型规模、缓存状态。首实例启动可以通过模型预热与缓存提前准备权重,再通过并发读取和流水线加载提高加载效率;批量扩容则可以复用已有节点的模型文件或GPU权重,减少重复下载和加载。
这些方式主要优化权重获取与加载过程。新实例仍需完成必要的框架初始化、编译、预热和就绪检查。因此,选择加速方案之前,需要先拆清楚实际启动耗时,再觉得采用什么方式来加速推理启动。